[HTTP의 기초를 찾아서 - 1편] HTTP의 특성부터 HTTP/3까지
HTTP가 무엇인지, 요청과 응답·미디어 독립·무상태·지속 연결이라는 네 가지 특성, 메시지 구조, 그리고 HTTP/0.9부터 HTTP/3까지의 발전을 정리했습니다.
이 글은
혼자 공부하는 네트워크책과 널널한 개발자님의외워서 끝내는 네트워크 핵심이론 - 기초강의를 참고해서 작성한 글입니다.
안녕하세요. 최근에 혼자 공부하는 네트워크라는 책과 널널한 개발자님의 외워서 끝내는 네트워크 핵심이론 - 기초 강의를 병행하며 네트워크를 학습하고 있습니다. 지금은 OSI 7계층 중 맨 위인 응용 계층(Application Layer)을 먼저 보고 있습니다. 보통은 아래 계층부터 공부하는데, 이번에는 거꾸로 위에서부터 보고 싶다는 생각이 들더라고요. 그래서 지난번에는 응용 계층에서 다른 서비스들의 기반이 되는 DNS를 알아보았고, 이번에는 HTTP를 정리해 보려고 합니다.
HTTP는 학습할 내용이 정말 많아서, 이 책과 강의만으로는 HTTP를 완벽하게 이해하기 어려울 거라고 생각합니다. 우선 책과 강의, 그리고 AI를 활용해 기초를 먼저 다지고, 부족하다고 느껴지면 HTTP 완벽 가이드라는 책과 컴퓨터 네트워킹: 하향식 접근이라는 책으로 더 자세히 파헤쳐 보려고 합니다.
그럼 HTTP 기초 학습의 첫걸음으로, HTTP가 무엇인지, 어떤 특성이 있는지, 메시지는 어떻게 생겼는지, 그리고 버전에 따라 어떻게 발전해 왔는지 알아보겠습니다.
HTTP란 무엇일까?
HTTP(Hypertext Transfer Protocol)는 웹에서 클라이언트와 서버가 정보를 주고받을 때 사용하는 응용 계층 프로토콜입니다. 브라우저 주소창에 주소를 입력하면 페이지가 뜨기까지 브라우저(클라이언트)와 웹 서버가 메시지를 주고받는데, 이때 따르는 약속이 HTTP입니다.
HTTP의 이름을 하나씩 뜯어 봅시다.
Hypertext: 다른 문서로 이동할 수 있는 링크(하이퍼링크)를 품은 텍스트입니다. 웹 페이지를 만드는 HTML(Hypertext Markup Language)이 대표적입니다.Transfer: 하이퍼텍스트를 전송한다는 의미입니다.Protocol: 서로 통신하기 위해 정해 둔 약속(규칙)입니다.
HTTP는 처음에 “하이퍼텍스트 문서를 주고받기 위한 약속”으로 만들어졌습니다. 1989년 CERN의 팀 버너스리가 월드 와이드 웹(WWW)을 제안했고, 1990년 말까지 이를 구현하면서 HTML, URL과 함께 만든 것이 HTTP입니다. (참고: CERN, Web@30) 지금은 HTML 문서뿐 아니라 이미지, 영상, JSON 데이터까지 거의 모든 종류의 데이터를 HTTP로 주고받습니다.
HTTP는 응용 계층 프로토콜이라, 데이터를 상대에게 실제로 실어 나르는 일은 아래 전송 계층(Transport Layer)에 맡깁니다. HTTP/3 이전 버전은 TCP 위에서, HTTP/3는 UDP 기반의 QUIC 위에서 동작합니다.
네트워크 계층별 역할이나 TCP, UDP가 아직 낯설다면 이 부분이 어렵게 느껴질 수 있습니다. 계층별 역할과 TCP, UDP는 이후 포스팅에서 따로 정리해서 찾아뵙겠습니다.
HTTP의 주요 4가지 특성
HTTP를 공부한다면 꼭 알아야 할 4가지 특성이 있습니다. 지금부터 이 4가지 특성을 하나씩 살펴보겠습니다.
(1) 요청과 응답을 기반으로 동작한다
클라이언트는 HTTP 요청 메시지로 서버에 필요한 자원을 요청하고, 서버는 HTTP 응답 메시지로 그 요청에 답합니다. 이때 대화는 항상 클라이언트가 먼저 시작합니다. 서버는 요청을 받기 전에 먼저 메시지를 보내지 않습니다.
예를 들어 클라이언트가 index.html을 요청하면, 서버는 요청 결과와 함께 HTML 문서를 돌려줍니다.
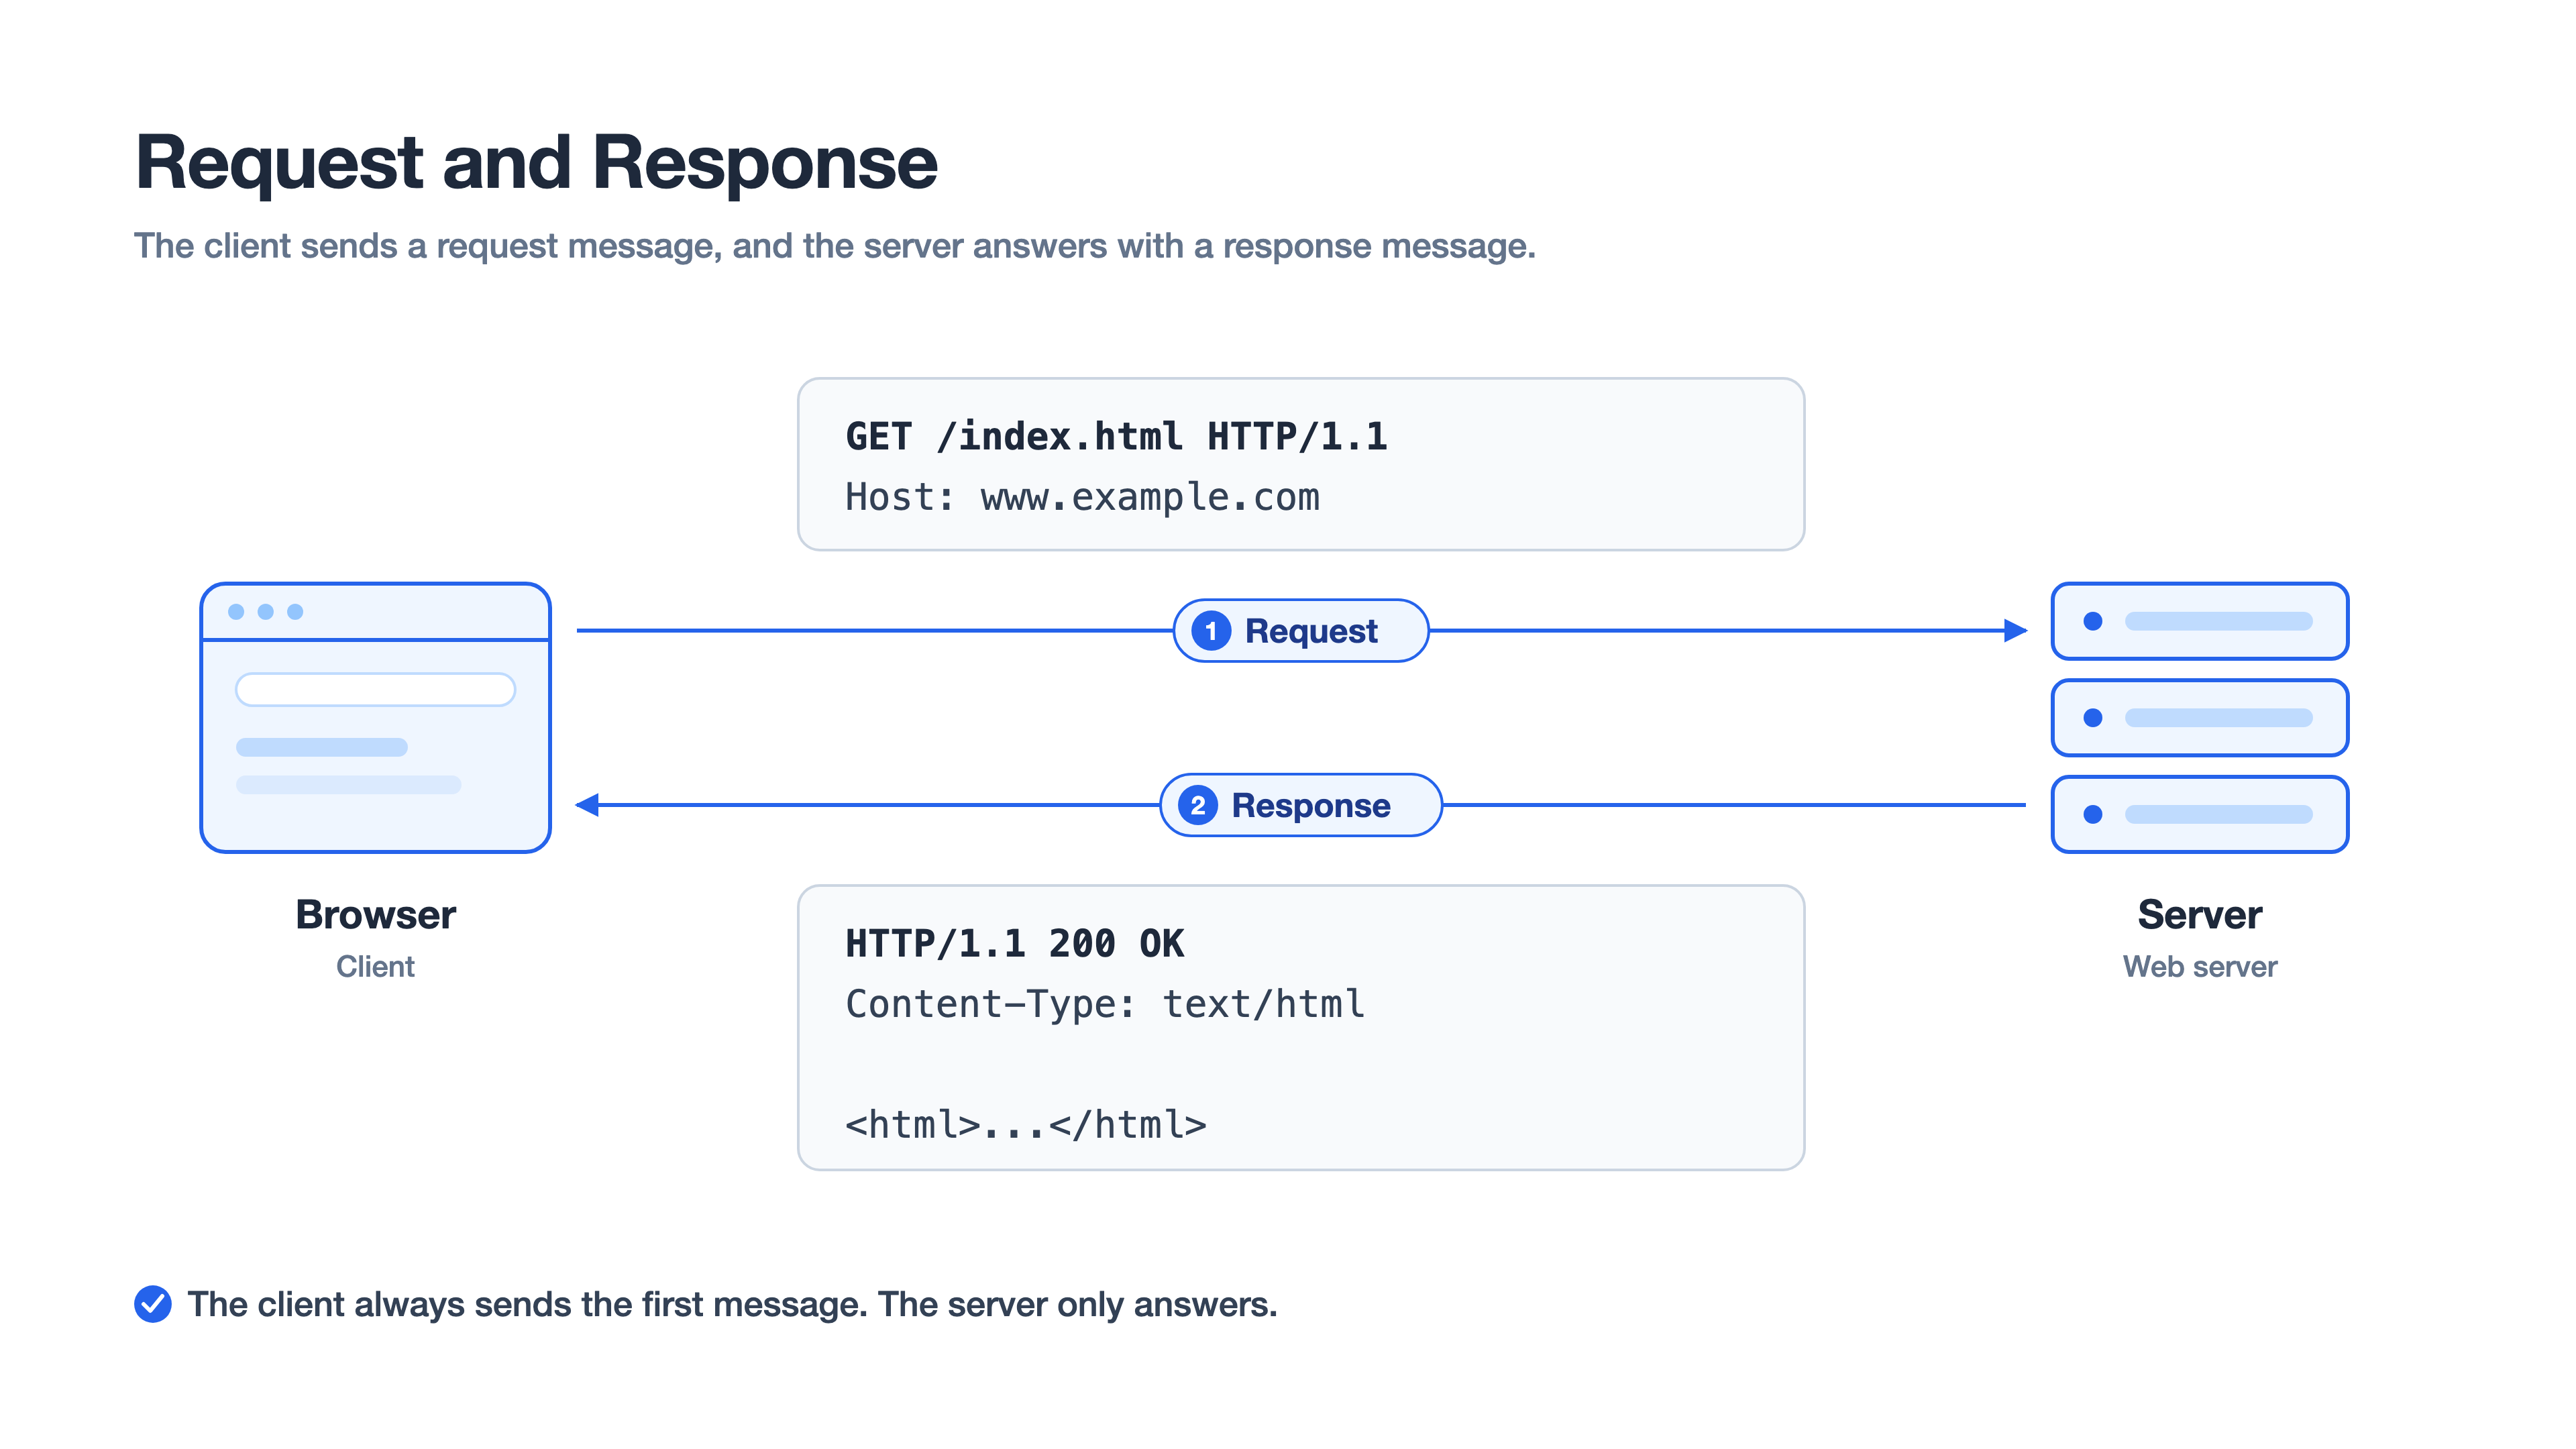 클라이언트가 먼저 요청하고, 서버는 그 요청에 응답한다
(2) 어떤 종류의 자원이든 주고받을 수 있다
HTTP 요청의 대상을 자원(Resource)이라고 부릅니다. HTTP 표준 문서인 RFC 9110의 3.1 Resources는 자원을 이렇게 설명합니다.
HTTP does not limit the nature of a resource; it merely defines an interface that might be used to interact with resources.
“HTTP는 자원의 성격을 제한하지 않는다. 자원과 상호작용할 때 쓸 수 있는 인터페이스를 정의할 뿐이다.”라는 뜻입니다.
즉, 자원이 디스크에 저장된 파일이든 데이터베이스의 데이터든 HTTP는 상관하지 않습니다. HTTP가 정하는 것은 자원을 다루는 공통 규칙, 즉 인터페이스뿐입니다. 대부분의 자원은 URI로 식별하고, GET, POST 같은 메서드로 무엇을 할지 말하며, 200, 204 같은 상태 코드와 헤더로 결과를 주고받습니다.
HTTP는 자원을 주고받는 형식에도 제한을 두지 않습니다. 같은 HTTP로 HTML 문서도, 이미지도, JSON 데이터도 주고받을 수 있습니다. 이런 특성을 미디어 독립적이라고 합니다.
형식이 자유로운 대신, 받는 쪽이 본문을 어떻게 해석해야 할지 알 수 있도록 메시지에 형식을 적어 보냅니다. 이때 쓰는 것이 미디어 타입(Media Type)이고, Content-Type 헤더에 담깁니다. 이메일로 다양한 형식의 데이터를 보내기 위해 만든 MIME(Multipurpose Internet Mail Extensions)에서 유래해서 MIME 타입이라고도 부릅니다.
미디어 타입은 타입/서브타입 형식으로 이루어져 있습니다.
| 미디어 타입 | 의미 |
|---|---|
text/html | HTML 문서 |
text/plain | 일반 텍스트 |
image/png | PNG 이미지 |
image/webp | WebP 이미지 |
application/json | JSON 데이터 |
필요하면 ; 뒤에 매개변수를 붙여 부가 정보를 알려 줄 수도 있습니다.
1
Content-Type: text/html; charset=UTF-8
“본문은 HTML 문서이고, 문서 안의 문자는 UTF-8로 인코딩되어 있다”는 뜻입니다. 여기서 인코딩은 문자를 컴퓨터가 저장하고 전송할 수 있는 바이트로 바꾸는 규칙을 말합니다.
(3) 상태를 기억하지 않는다
HTTP는 상태를 유지하지 않는 무상태(Stateless) 프로토콜입니다. 서버가 HTTP 요청을 보낸 클라이언트와 관련된 상태를 기억하지 않는다는 의미입니다.
예를 들어 클라이언트가 로그인 요청을 보내 인증에 성공했더라도, 서버는 다음 요청에서 그 클라이언트가 로그인했다는 사실을 기억하지 않습니다. 서버 입장에서 모든 요청은 서로 관계없는 새로운 요청입니다. 그래서 클라이언트는 요청을 보낼 때마다 처리에 필요한 정보를 모두 담아 보내야 합니다.
그렇다면 HTTP는 왜 상태를 기억하지 않도록 만들어졌을까요?
HTTP 서버는 보통 많은 클라이언트와 동시에 상호작용합니다. 동시에 처리해야 할 요청은 수천에서 수백만 개에 이를 수 있고, 이 모든 클라이언트의 상태를 기억하는 것은 서버에 큰 부담입니다.
또 서버는 한 대가 아니라 여러 대로 구성되는 경우가 많습니다. 만약 HTTP가 상태를 유지하는(Stateful) 프로토콜이라면, 클라이언트의 상태는 처음 요청을 처리한 서버에만 남습니다. 그러면 클라이언트는 계속 그 서버와만 통신해야 하므로 특정 서버에 묶이게 됩니다. 다른 서버도 그 클라이언트를 처리하게 하려면 모든 서버가 모든 클라이언트의 상태를 공유해야 하는데, 이 작업은 번거롭고 복잡합니다.
반면 서버가 상태를 기억하지 않으면 어느 서버가 요청을 받아도 똑같이 처리할 수 있습니다. 그래서 무상태 프로토콜에는 두 가지 장점이 있습니다.
- 확장성: 요청이 늘어나면 언제든 서버를 쉽게 추가할 수 있습니다.
- 견고성: 서버 하나에 문제가 생겨도 다른 서버가 대신 요청을 처리할 수 있습니다.
그렇다면 로그인 상태 유지 같은 기능은 어떻게 만들까요? HTTP 자체는 상태를 기억하지 않지만, 쿠키와 세션을 이용하면 상태를 유지하는 것처럼 동작하게 만들 수 있습니다. 이 내용은 3편에서 다룹니다.
(4) 연결을 재사용한다
HTTP는 TCP 연결 위에서 메시지를 주고받습니다. 연결을 맺는 일은 HTTP가 아니라 전송 계층의 TCP가 맡습니다. TCP는 데이터를 주고받기 전에 3-way handshake(연결 전에 세 번 주고받는 인사)로 먼저 연결을 맺는 연결형 프로토콜입니다.
초기 HTTP(1.0 이하)는 요청 하나마다 TCP 연결을 새로 맺고, 응답을 받으면 바로 끊었습니다. 추가로 요청할 것이 있으면 다시 연결을 맺어야 했는데, 이런 방식을 비지속 연결(Non-persistent Connection)이라고 합니다.
예를 들어 HTML 문서 하나와 이미지 10장으로 이루어진 페이지를 연다면, HTML에 1번, 이미지에 10번, 모두 11번 연결을 맺고 끊어야 합니다. 실제 데이터를 받기도 전에 연결을 맺는 데만 시간을 반복해서 쓰는 셈입니다.
이 문제를 해결하기 위해 HTTP/1.1부터는 지속 연결(Persistent Connection)이 기본 동작이 되었습니다. 한 번 맺은 TCP 연결로 여러 요청과 응답을 주고받는 방식으로, keep-alive라고도 부릅니다. 위의 페이지라면 연결 한 번으로 HTML과 이미지 10장을 모두 받을 수 있습니다.
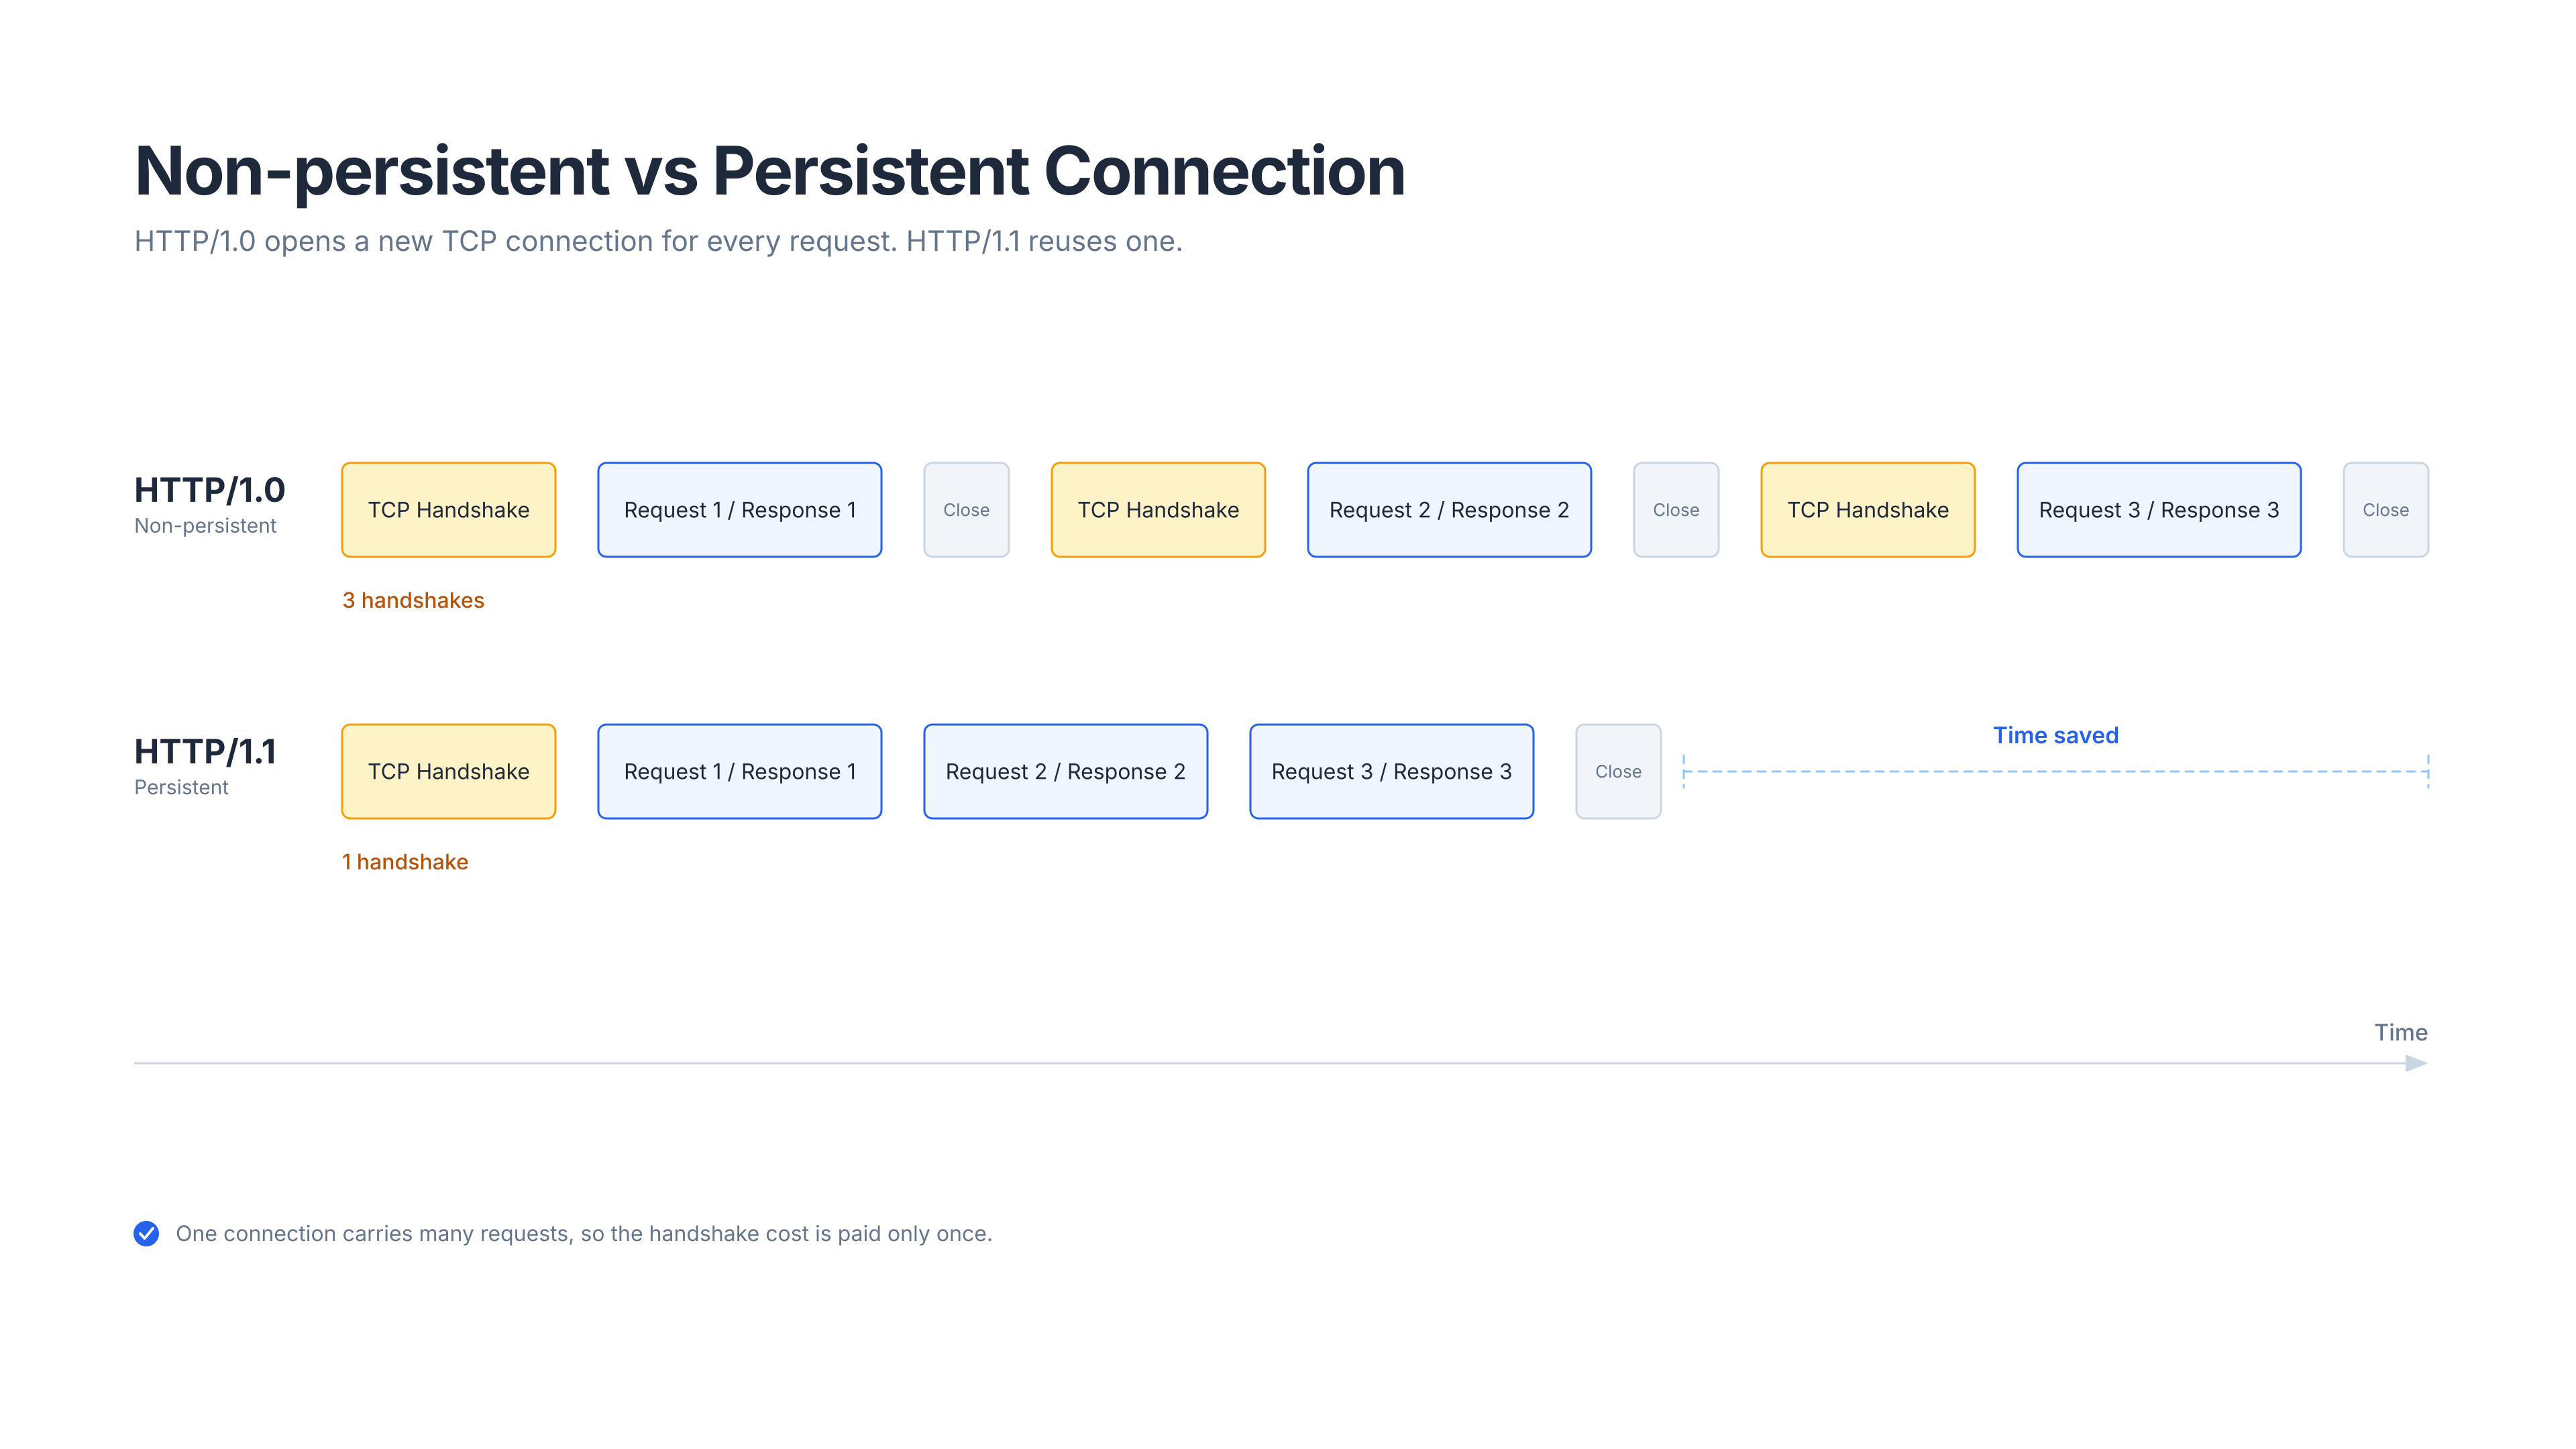 비지속 연결은 요청마다 handshake를 반복하고, 지속 연결은 한 번만 한다
지속 연결이라고 해서 연결을 영원히 유지하는 것은 아닙니다. 연결을 끝내고 싶은 쪽은 Connection: close 헤더로 상대에게 알릴 수 있고, 서버는 일정 시간 동안 요청이 없으면 연결을 닫습니다. 쓰지 않는 연결이 서버 자원을 계속 차지하지 않도록 하기 위해서입니다.
HTTP/3는 TCP 대신 UDP 기반의 QUIC 위에서 동작하지만, QUIC도 연결을 맺고 재사용합니다. QUIC이 무엇인지, 버전별로 무엇이 달라졌는지는 아래 “HTTP는 어떻게 발전해 왔을까?”에서 자세히 살펴보겠습니다. TCP와 UDP 자체에 대해서는 이후 포스팅에서 따로 정리해서 찾아뵙겠습니다.
흔히 HTTP의 특징으로 “비연결성(Connectionless)”을 꼽기도 합니다. 요청과 응답이 끝나면 연결을 끊는다는 뜻인데, 이는 HTTP/1.0까지의 동작입니다. HTTP/1.1부터는 지속 연결이 기본입니다.
HTTP 메시지는 어떻게 생겼을까?
앞에서 클라이언트와 서버는 요청 메시지와 응답 메시지를 주고받는다고 했습니다. 이번에는 그 메시지가 실제로 어떻게 생겼는지 살펴보겠습니다.
HTTP 메시지는 크게 시작 라인, 필드 라인, 메시지 본문으로 이루어져 있습니다.
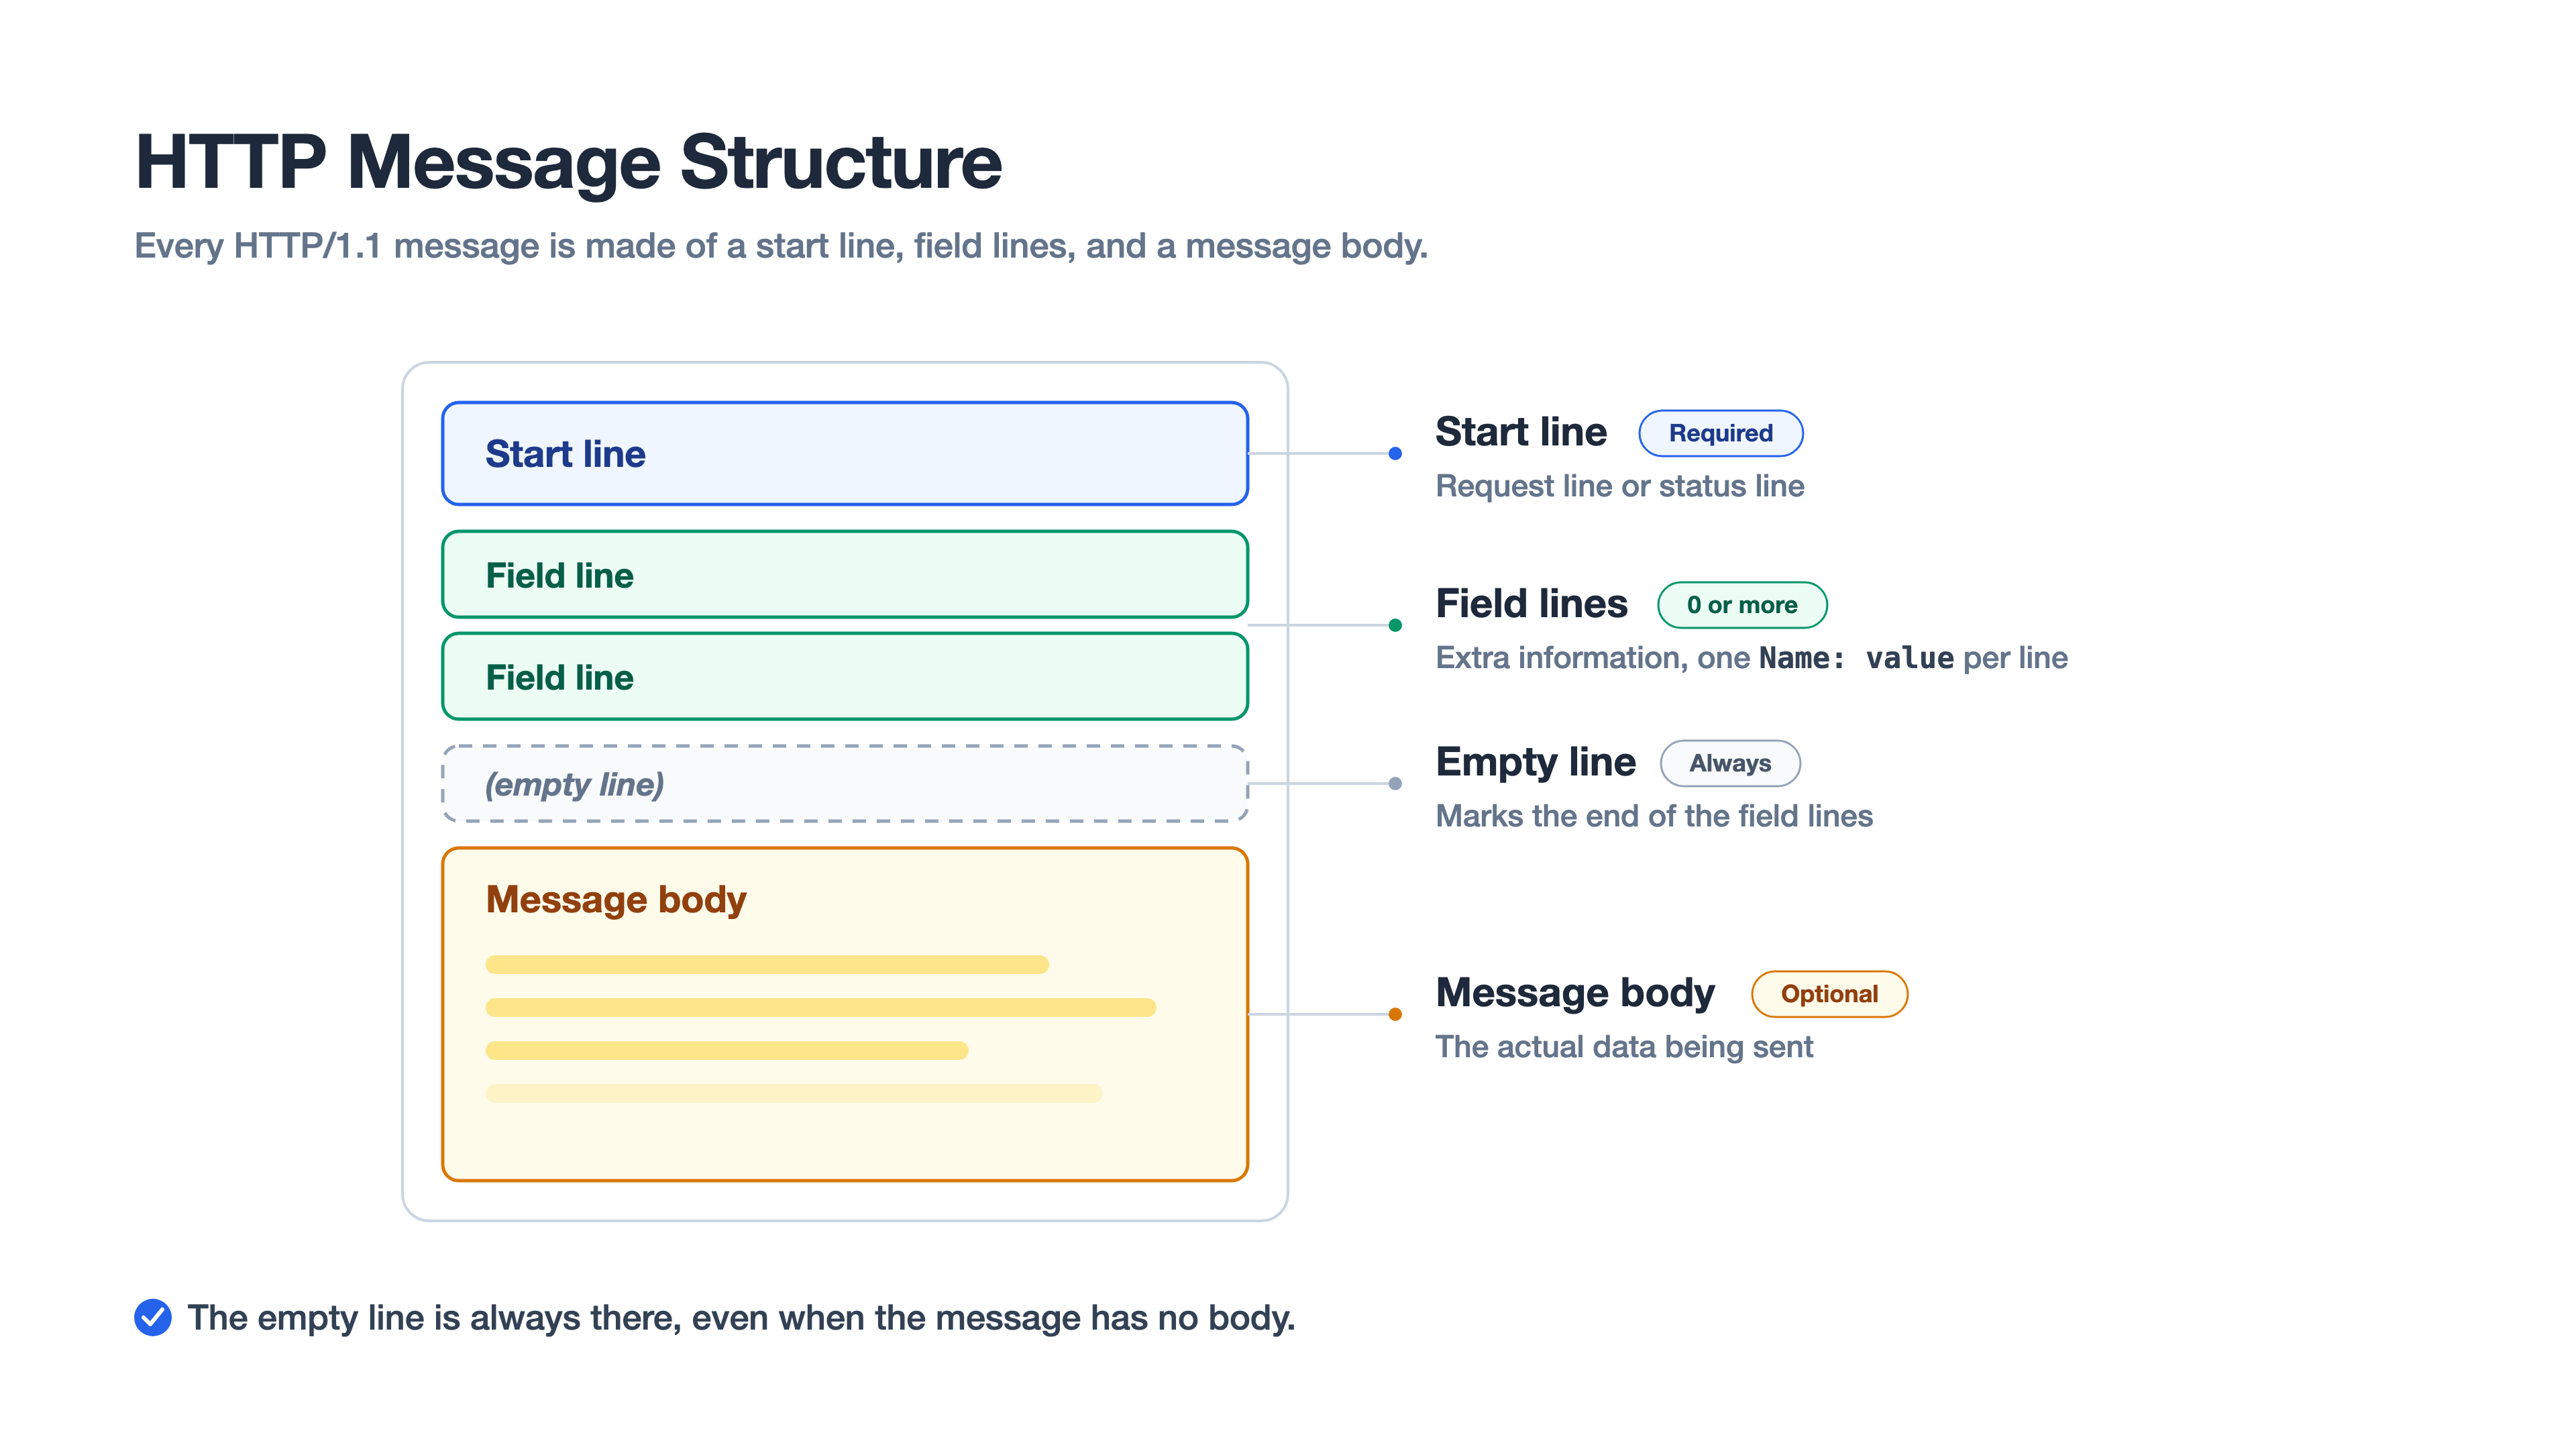 HTTP 메시지는 시작 라인, 필드 라인, 빈 줄, 메시지 본문 순서로 이루어진다
- 시작 라인: 메시지의 핵심을 담은 첫 줄입니다. 요청이라면 무엇을 요청하는지, 응답이라면 결과가 어떤지를 나타냅니다.
- 필드 라인: 메시지에 대한 부가 정보입니다. 없을 수도 있고 여러 줄일 수도 있습니다.
- 빈 줄: 필드 라인이 끝났음을 알리는 구분선입니다.
- 메시지 본문: 실제로 주고받는 데이터입니다. 없을 수도 있습니다.
빈 줄은 본문이 없는 메시지에도 반드시 들어갑니다. 받는 쪽은 빈 줄을 보고 나서야 필드 라인이 여기서 끝났다는 것을 알 수 있기 때문입니다.
실제 메시지로 확인해 보겠습니다. 아래는 CERN이 복원해 둔 세계 최초의 웹 페이지를 요청했을 때 주고받은 메시지입니다. (응답의 필드 라인과 본문은 일부만 옮겼습니다.)
1
2
3
4
5
6
7
8
9
10
11
12
13
<요청 메시지>
GET /hypertext/WWW/TheProject.html HTTP/1.1
Host: info.cern.ch

<응답 메시지>
HTTP/1.1 200 OK
Server: Apache
Content-Type: text/html
Content-Length: 2217

<HEADER>
<TITLE>The World Wide Web project</TITLE>
...
요청 메시지는 본문이 없어서 Host 줄 다음의 빈 줄로 끝납니다. 응답 메시지는 빈 줄 다음에 HTML 문서가 본문으로 이어집니다.
시작 라인
시작 라인은 요청 메시지인지 응답 메시지인지에 따라 모양이 다릅니다. 요청 메시지의 시작 라인은 요청 라인, 응답 메시지의 시작 라인은 상태 라인이라고 부릅니다.
요청 라인은 메서드 요청대상 HTTP버전 순서로, 각 요소를 공백으로 구분합니다.
| 요소 | 의미 | 예시 |
|---|---|---|
| 메서드 | 자원에 어떤 작업을 할지 | GET, POST, PUT, DELETE |
| 요청 대상 | 어떤 자원인지 (보통 URI의 경로와 쿼리) | /hello?q=world |
| HTTP 버전 | 어떤 버전의 규칙을 따르는지 | HTTP/1.1 |
예를 들어 http://www.example.com/hello?q=world에 요청한다면 요청 대상은 /hello?q=world가 됩니다. 호스트 부분인 www.example.com은 요청 대상이 아니라 Host 필드 라인에 따로 적습니다.
요청 대상이 같더라도 메서드가 다르면 서로 다른 요청입니다. GET /users/1은 1번 사용자를 조회하는 요청이고, DELETE /users/1은 1번 사용자를 삭제하는 요청입니다.
상태 라인은 HTTP버전 상태코드 이유구문 순서입니다.
| 요소 | 의미 | 예시 |
|---|---|---|
| HTTP 버전 | 응답에 사용한 HTTP 버전 | HTTP/1.1 |
| 상태 코드 | 요청을 처리한 결과를 나타내는 세 자리 숫자 | 200, 404 |
| 이유 구문 | 상태 코드를 사람이 읽기 쉽게 풀어 쓴 설명 | OK, Not Found |
이유 구문은 사람을 위한 설명일 뿐이고, 프로그램은 상태 코드 숫자를 보고 결과를 판단합니다. 메서드와 상태 코드는 다음 편에서 자세히 다루겠습니다.
필드 라인
필드 라인은 한 줄에 하나씩 이름: 값 형태로 씁니다.
1
2
3
Host: info.cern.ch
Content-Type: text/html
Content-Length: 2217
어느 호스트로 보내는지(Host), 본문이 어떤 형식인지(Content-Type), 본문이 몇 바이트인지(Content-Length)처럼 메시지에 대한 부가 정보를 담습니다. 필드 이름은 대소문자를 구분하지 않아서 host와 Host는 같은 필드입니다.
필드 라인은 흔히 헤더(Header)라고 부르며, 자주 쓰는 헤더는 3편에서 자세히 살펴보겠습니다.
지금까지 본 텍스트 형식은 HTTP/1.1 기준입니다. HTTP/2와 HTTP/3는 같은 정보를 바이너리 프레임이라는 다른 형식으로 나눠 보내지만, 메서드, 상태 코드, 헤더, 본문이라는 메시지의 의미는 그대로입니다.
HTTP는 어떻게 발전해 왔을까?
HTTP는 처음 등장한 뒤로 여러 번 버전이 바뀌었습니다. 버전마다 무엇이 추가됐는지 외우기보다, 이전 버전의 어떤 불편함을 해결하려고 바뀌었는지를 따라가면 훨씬 이해하기 쉽습니다.
HTTP/1.1까지는
1.0,1.1처럼 소수점을 붙여 부르지만, 그 뒤 버전의 공식 이름은HTTP/2,HTTP/3입니다. 흔히2.0,3.0이라고도 부릅니다.
HTTP/0.9: 가장 단순했던 시작
1991년에 정리된 초창기 HTTP는 아주 단순했습니다.
- 메서드는
GET하나만 쓸 수 있었습니다. - 요청 메시지는 한 줄로 끝났습니다.
- 헤더와 상태 코드가 없었습니다.
1
GET /index.html
요청은 이 한 줄이 전부였고, 응답으로는 HTML 문서만 돌아왔습니다. 앞에서 본 메시지 구조와 비교하면 HTTP 버전도, 필드 라인도 없는 셈입니다. 그래서 HTML 외의 자원을 주고받거나, 요청과 응답에 부가 정보를 담을 방법이 없었습니다.
HTTP/1.0: 헤더의 등장
1996년에 문서로 정리된 HTTP/1.0에서 지금 우리에게 익숙한 HTTP의 모습이 갖춰지기 시작했습니다.
HEAD,POST처럼GET이외의 메서드가 도입되었습니다.- 응답에 상태 코드가 생겨서, 요청이 성공했는지 실패했는지 알 수 있게 되었습니다.
- 헤더를 지원하기 시작했습니다. 특히
Content-Type헤더 덕분에 HTML 외에 이미지 같은 다양한 형식의 자원도 주고받을 수 있게 되었습니다.
하지만 앞의 (4)에서 본 것처럼, 1.0은 요청과 응답을 한 번 주고받을 때마다 TCP 연결을 새로 맺고 끊는 비지속 연결 방식이었습니다. 웹 페이지 하나에 이미지, CSS, JavaScript 파일이 수십 개씩 붙으면서, 연결을 맺고 끊는 비용은 점점 커졌습니다.
HTTP/1.1: 연결을 재사용하자
지속 연결
1997년에 나온 HTTP/1.1에서는 지속 연결이 기본 동작이 되었습니다. 한 번 맺은 TCP 연결 위에서 여러 요청과 응답을 주고받으니, 1.0에서 매번 반복하던 연결 비용이 크게 줄었습니다. 자세한 동작은 앞의 (4)에서 살펴봤습니다.
Host 헤더 필수와 그 밖의 변화
1.1에서는 Host 헤더가 필수가 되어 서버 한 대에서 여러 도메인의 사이트를 운영할 수 있게 되었습니다. 콘텐츠 협상처럼 다양한 편의 기능과 헤더도 추가되었습니다.
파이프라이닝
1.1에서는 파이프라이닝(Pipelining)도 도입되었습니다. 앞선 요청의 응답을 받기 전에 다음 요청을 미리 보내는 기능입니다.
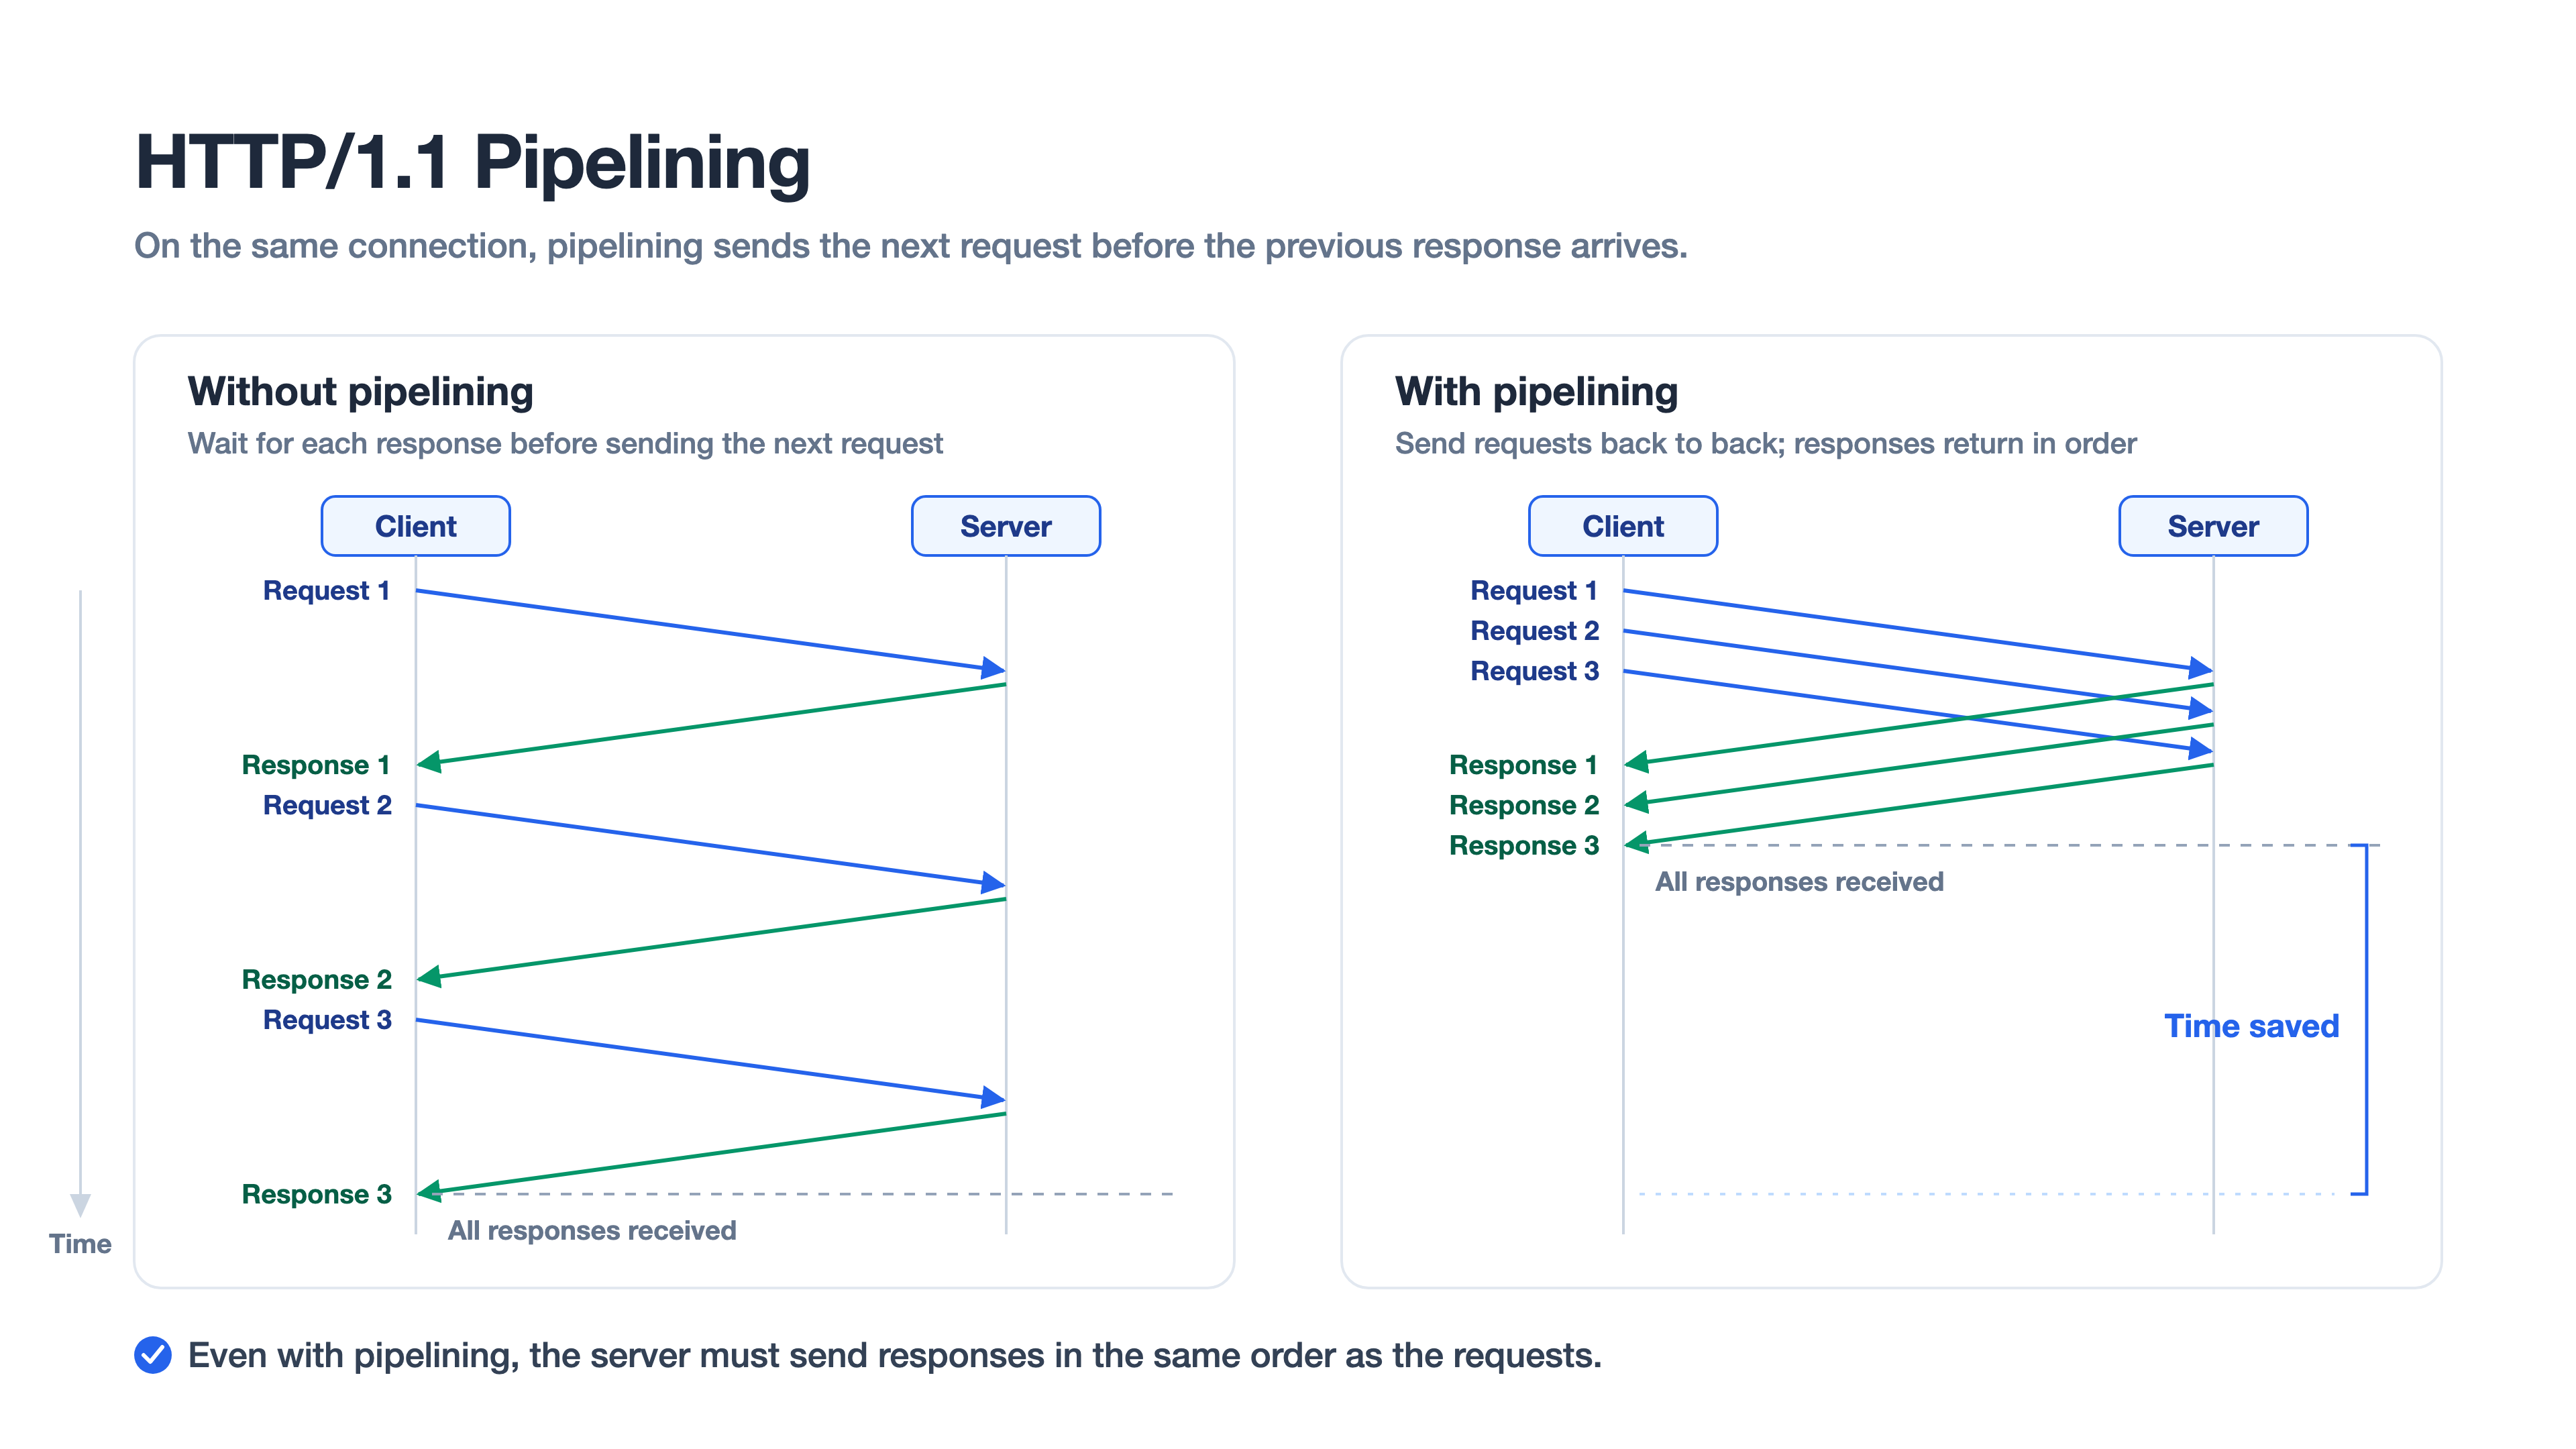 파이프라이닝은 응답을 기다리지 않고 요청을 연달아 보내지만, 응답은 요청한 순서대로 돌아온다
1.1 버전의 고질적인 문제: HOL 블로킹
HOL 블로킹(Head-Of-Line Blocking)은 같은 줄에서 순서대로 처리되는 작업들 중, 맨 앞의 작업이 지연되면 뒤의 작업들도 모두 함께 지연되는 문제입니다.
마트 계산대를 떠올려 보세요. 앞사람이 물건을 잔뜩 사서 계산이 오래 걸리면, 뒤에 선 사람은 물건을 하나만 샀어도 계속 기다려야 합니다.
1.1의 파이프라이닝이 바로 이런 상황입니다. 요청은 한꺼번에 보낼 수 있어도, 응답은 반드시 요청한 순서대로 돌아와야 합니다. 그래서 요청 1의 응답이 늦어지면, 요청 2와 요청 3의 응답이 먼저 준비되어도 요청 1의 응답이 끝날 때까지 기다려야 합니다.
이 문제에 더해, 파이프라이닝을 제대로 처리하지 못하는 서버와 프록시도 많아서 실제로 대부분의 브라우저는 파이프라이닝을 사용하지 않았습니다. 대신 같은 서버에 TCP 연결을 여러 개(보통 서버 하나당 6개 정도) 열어 요청을 나눠 보내는 방식으로 버텼습니다.
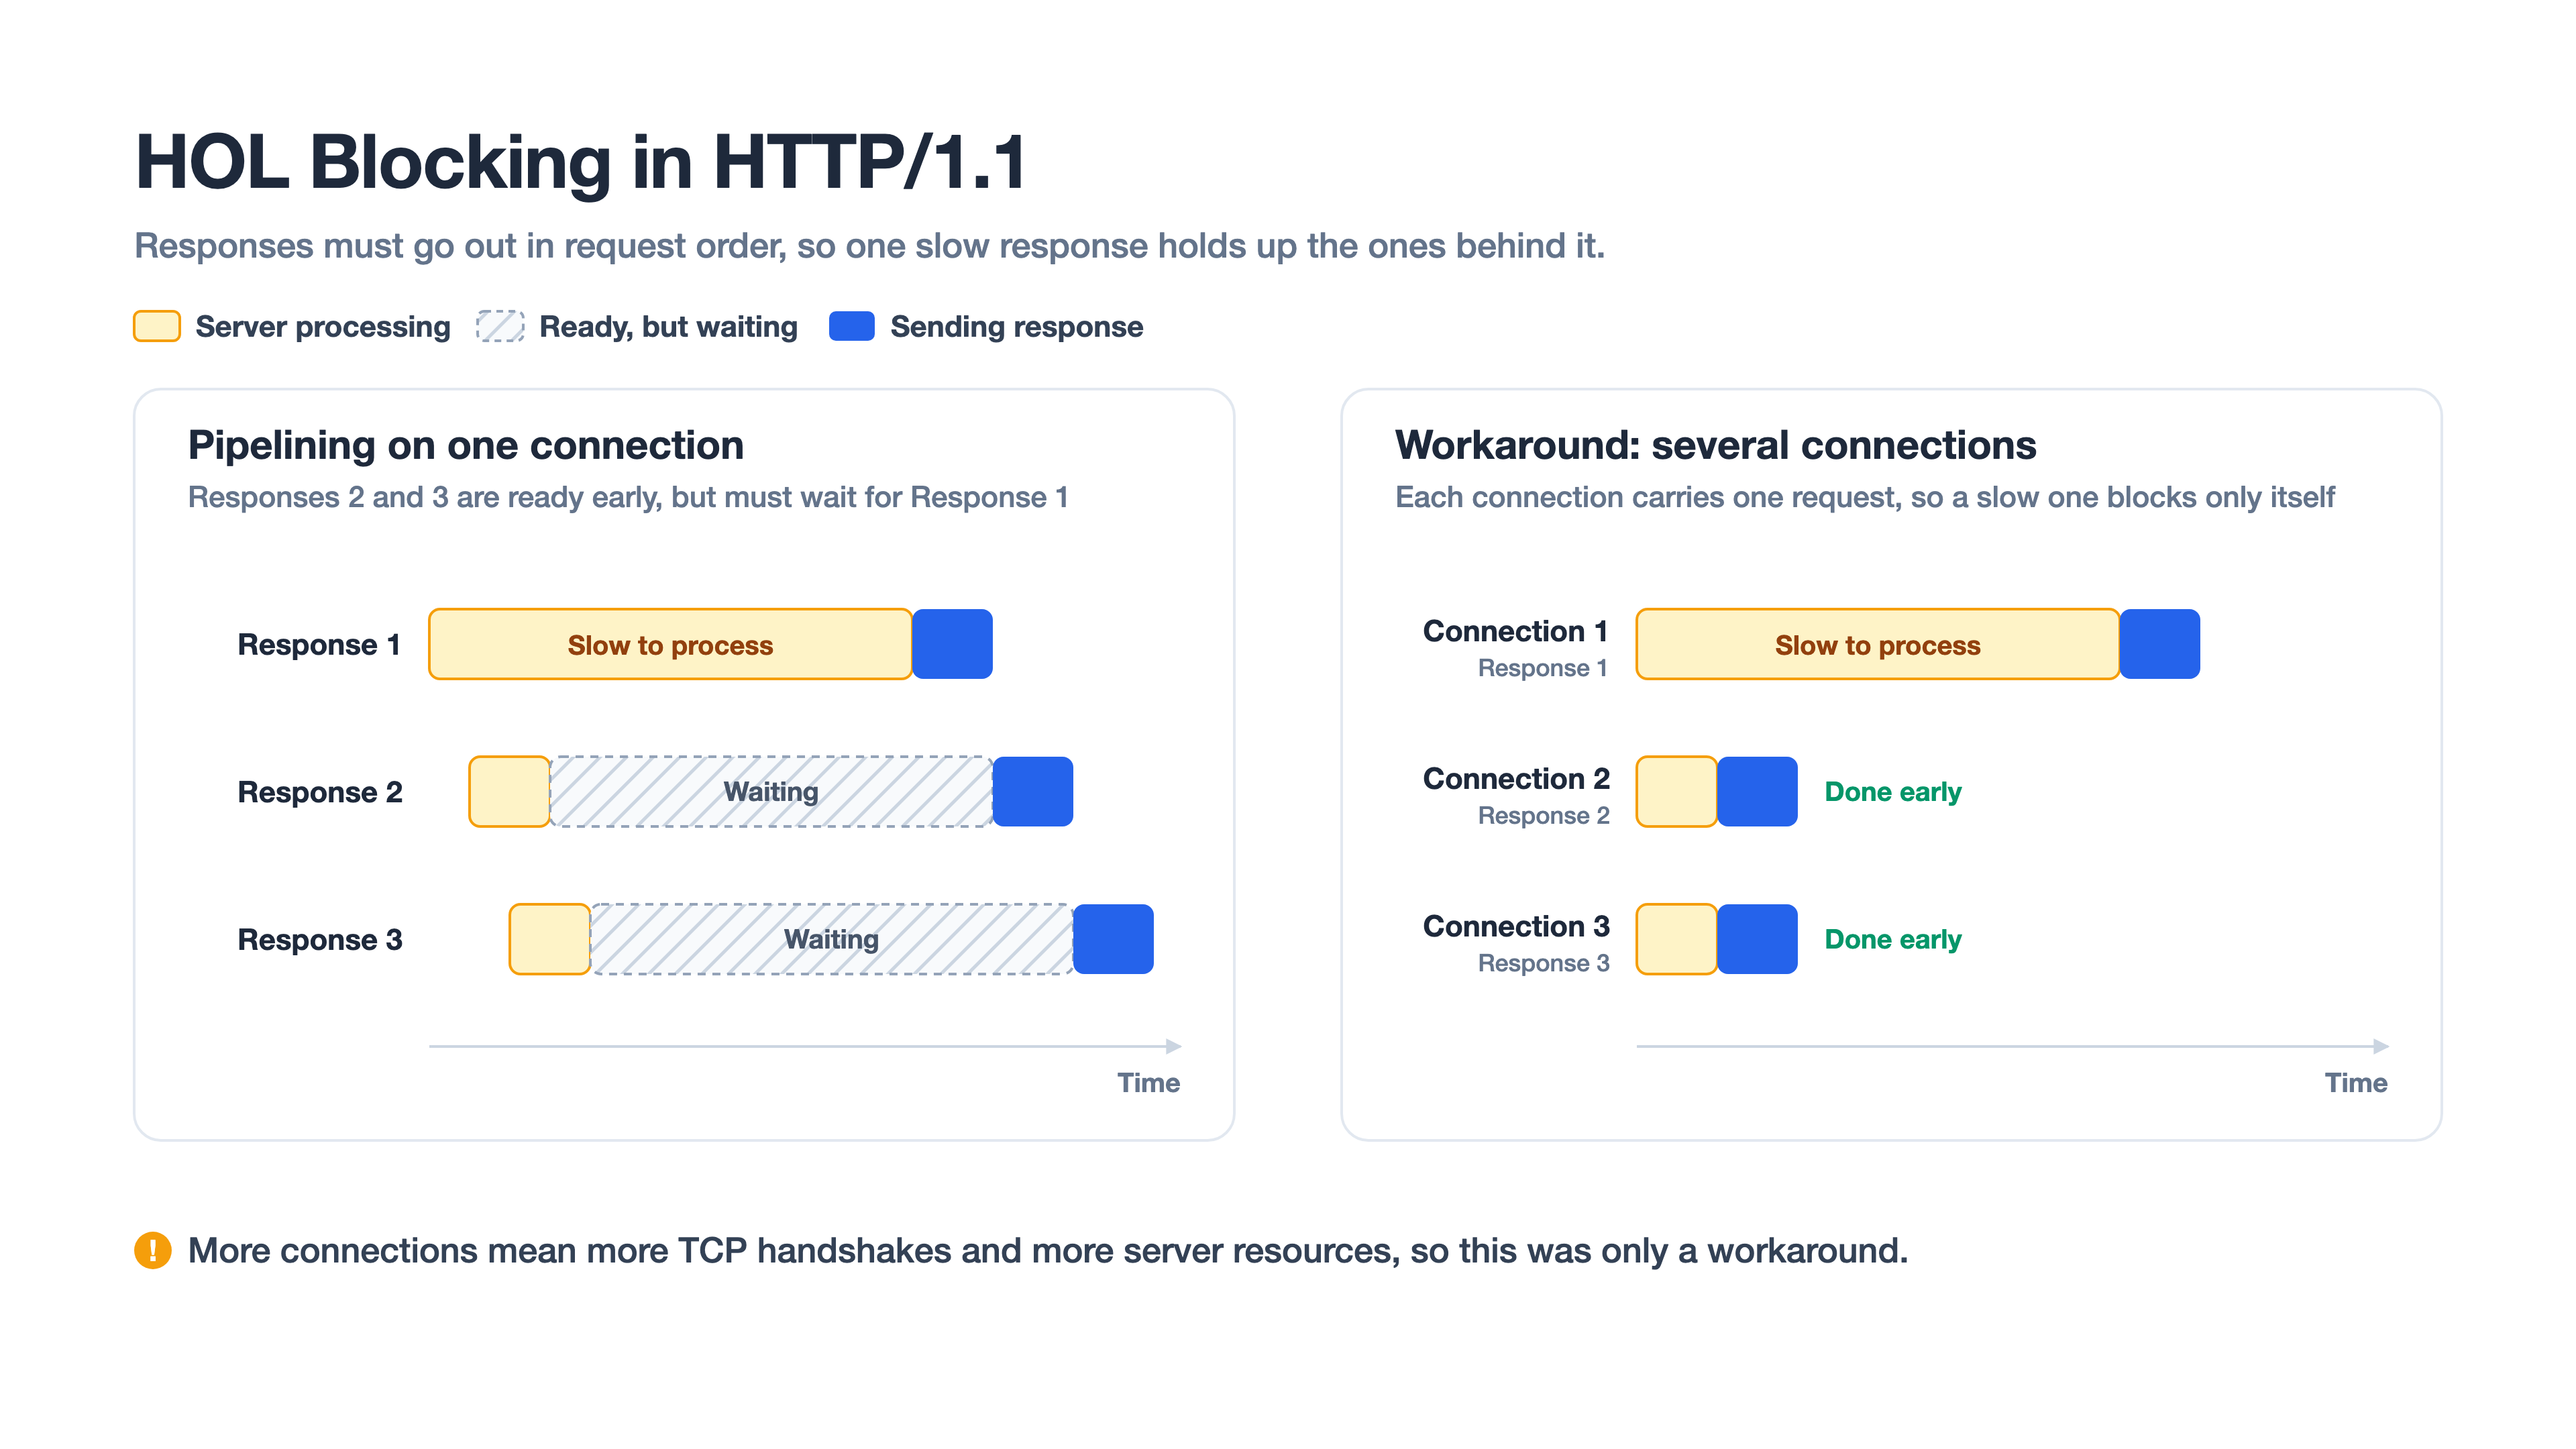 파이프라이닝에서는 느린 응답 하나가 뒤의 응답을 모두 막고, 연결을 여러 개 열면 서로 막지 않는다
HTTP/2: 하나의 연결로 여러 요청을 동시에
2015년에 나온 HTTP/2는 1.1의 성능 문제를 해결하는 데 집중했습니다.
바이너리 프레임과 헤더 압축
- 앞에서 본 메시지는 사람이 읽을 수 있는 텍스트 형식이었지만, HTTP/2는 메시지를 바이너리 형식으로 주고받습니다. 메시지를
프레임(Frame)이라는 작은 단위로 나눠 보내며, 메서드, 상태 코드, 헤더, 본문이라는 메시지의 의미는 그대로입니다. - 송수신 효율을 높이기 위해 헤더를 압축해서 전송합니다. 요청마다 거의 똑같은 헤더가 반복되는 경우가 많아서 압축 효과가 큽니다.
멀티플렉싱으로 HOL 블로킹 완화
HTTP/2는 1.1의 HOL 블로킹을 멀티플렉싱(Multiplexing)으로 완화했습니다. 멀티플렉싱은 하나의 연결 안에 여러 개의 스트림(Stream)을 두고, 병렬적으로 메시지를 주고받는 기술입니다.
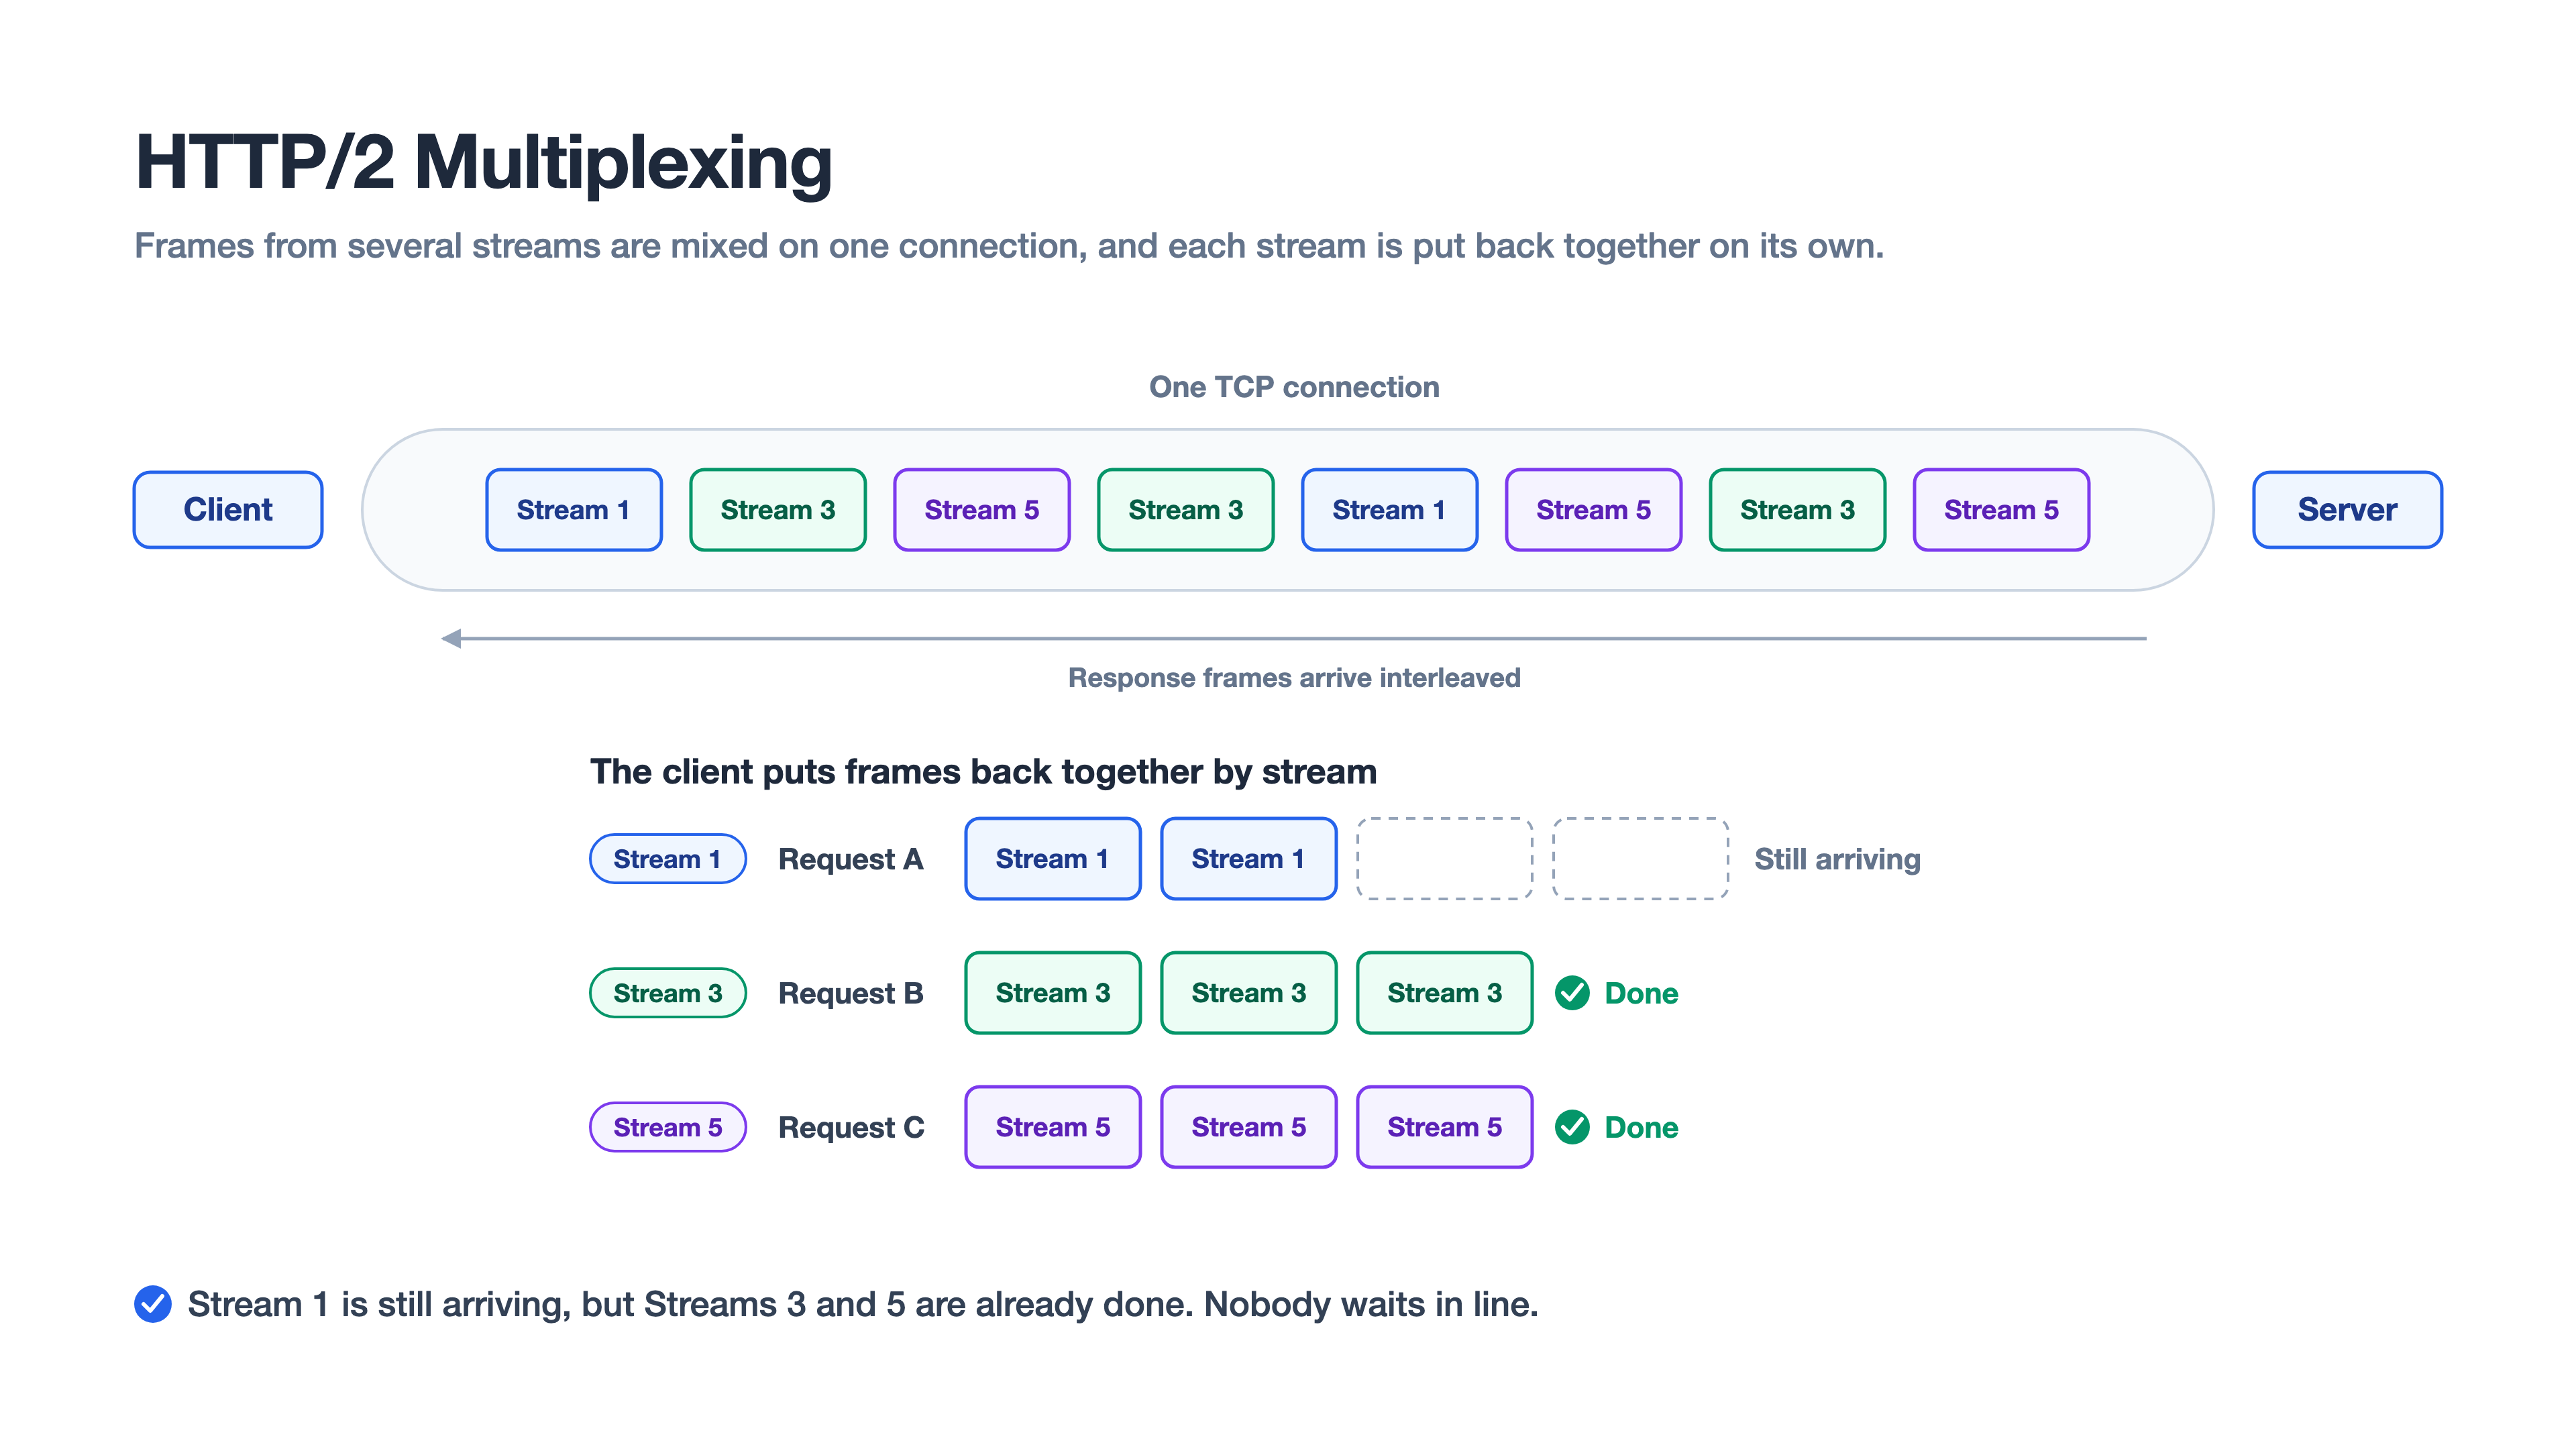 여러 스트림의 프레임이 한 연결에 섞여 오가고, 스트림마다 따로 다시 모인다
요청과 응답이 각자의 스트림으로 프레임 단위로 섞여서 오가기 때문에, 순서를 기다릴 필요가 없습니다. 요청 A의 응답이 늦어져도 요청 B와 요청 C의 응답은 먼저 도착할 수 있습니다. 계산대에 비유하면, 줄을 하나로 세우지 않고 손님마다 각자 계산하는 셈입니다.
서버 푸시
클라이언트가 요청하지 않았더라도, 앞으로 필요할 것으로 예상되는 자원을 서버가 미리 보내 주는 서버 푸시(Server Push) 기능도 도입되었습니다. 예를 들어 HTML을 요청받았을 때, 그 HTML이 쓸 CSS 파일을 함께 보내 주는 식입니다. 서버 푸시도 클라이언트의 요청에 딸려서 보내는 것이라, 앞에서 말한 “대화는 항상 클라이언트가 먼저 시작한다”는 원칙이 깨지는 것은 아닙니다.
서버 푸시는 기대만큼 효과를 보기 어려웠습니다. 클라이언트가 이미 캐시해 둔 자원까지 다시 보내는 경우가 많았기 때문입니다. 그래서 Chrome은 2022년에 서버 푸시 지원을 중단했고, 지금은 실무에서 거의 쓰이지 않습니다.
그래도 남은 문제: TCP의 HOL 블로킹
멀티플렉싱으로 HTTP 단계의 HOL 블로킹은 해결했지만, TCP 단계의 HOL 블로킹은 여전히 남아 있었습니다.
TCP는 데이터를 반드시 보낸 순서대로 전달합니다. 그래서 중간에 패킷 하나가 유실되면, 그 패킷이 다시 전송될 때까지 뒤에 도착한 패킷들도 모두 기다리게 합니다.
HTTP/2에서는 모든 스트림이 하나의 TCP 연결을 함께 쓰기 때문에, 스트림 1의 패킷 하나가 유실되면 상관없는 스트림 3과 스트림 5까지 함께 멈춥니다. HTTP가 아무리 스트림을 나눠도, 그 아래의 TCP는 스트림을 구분하지 못하기 때문입니다.
HTTP/3: TCP 대신 UDP 위의 QUIC으로
QUIC
지금까지의 HTTP는 모두 TCP 위에서 동작했지만, 2022년에 표준이 된 HTTP/3는 UDP 위에서 동작합니다. 정확히는 UDP를 기반으로 구현된 QUIC 프로토콜 위에서 동작합니다. QUIC은 원래 Quick UDP Internet Connections의 줄임말로 출발했지만, 지금 표준에서는 줄임말이 아닌 이름 그대로 씁니다.
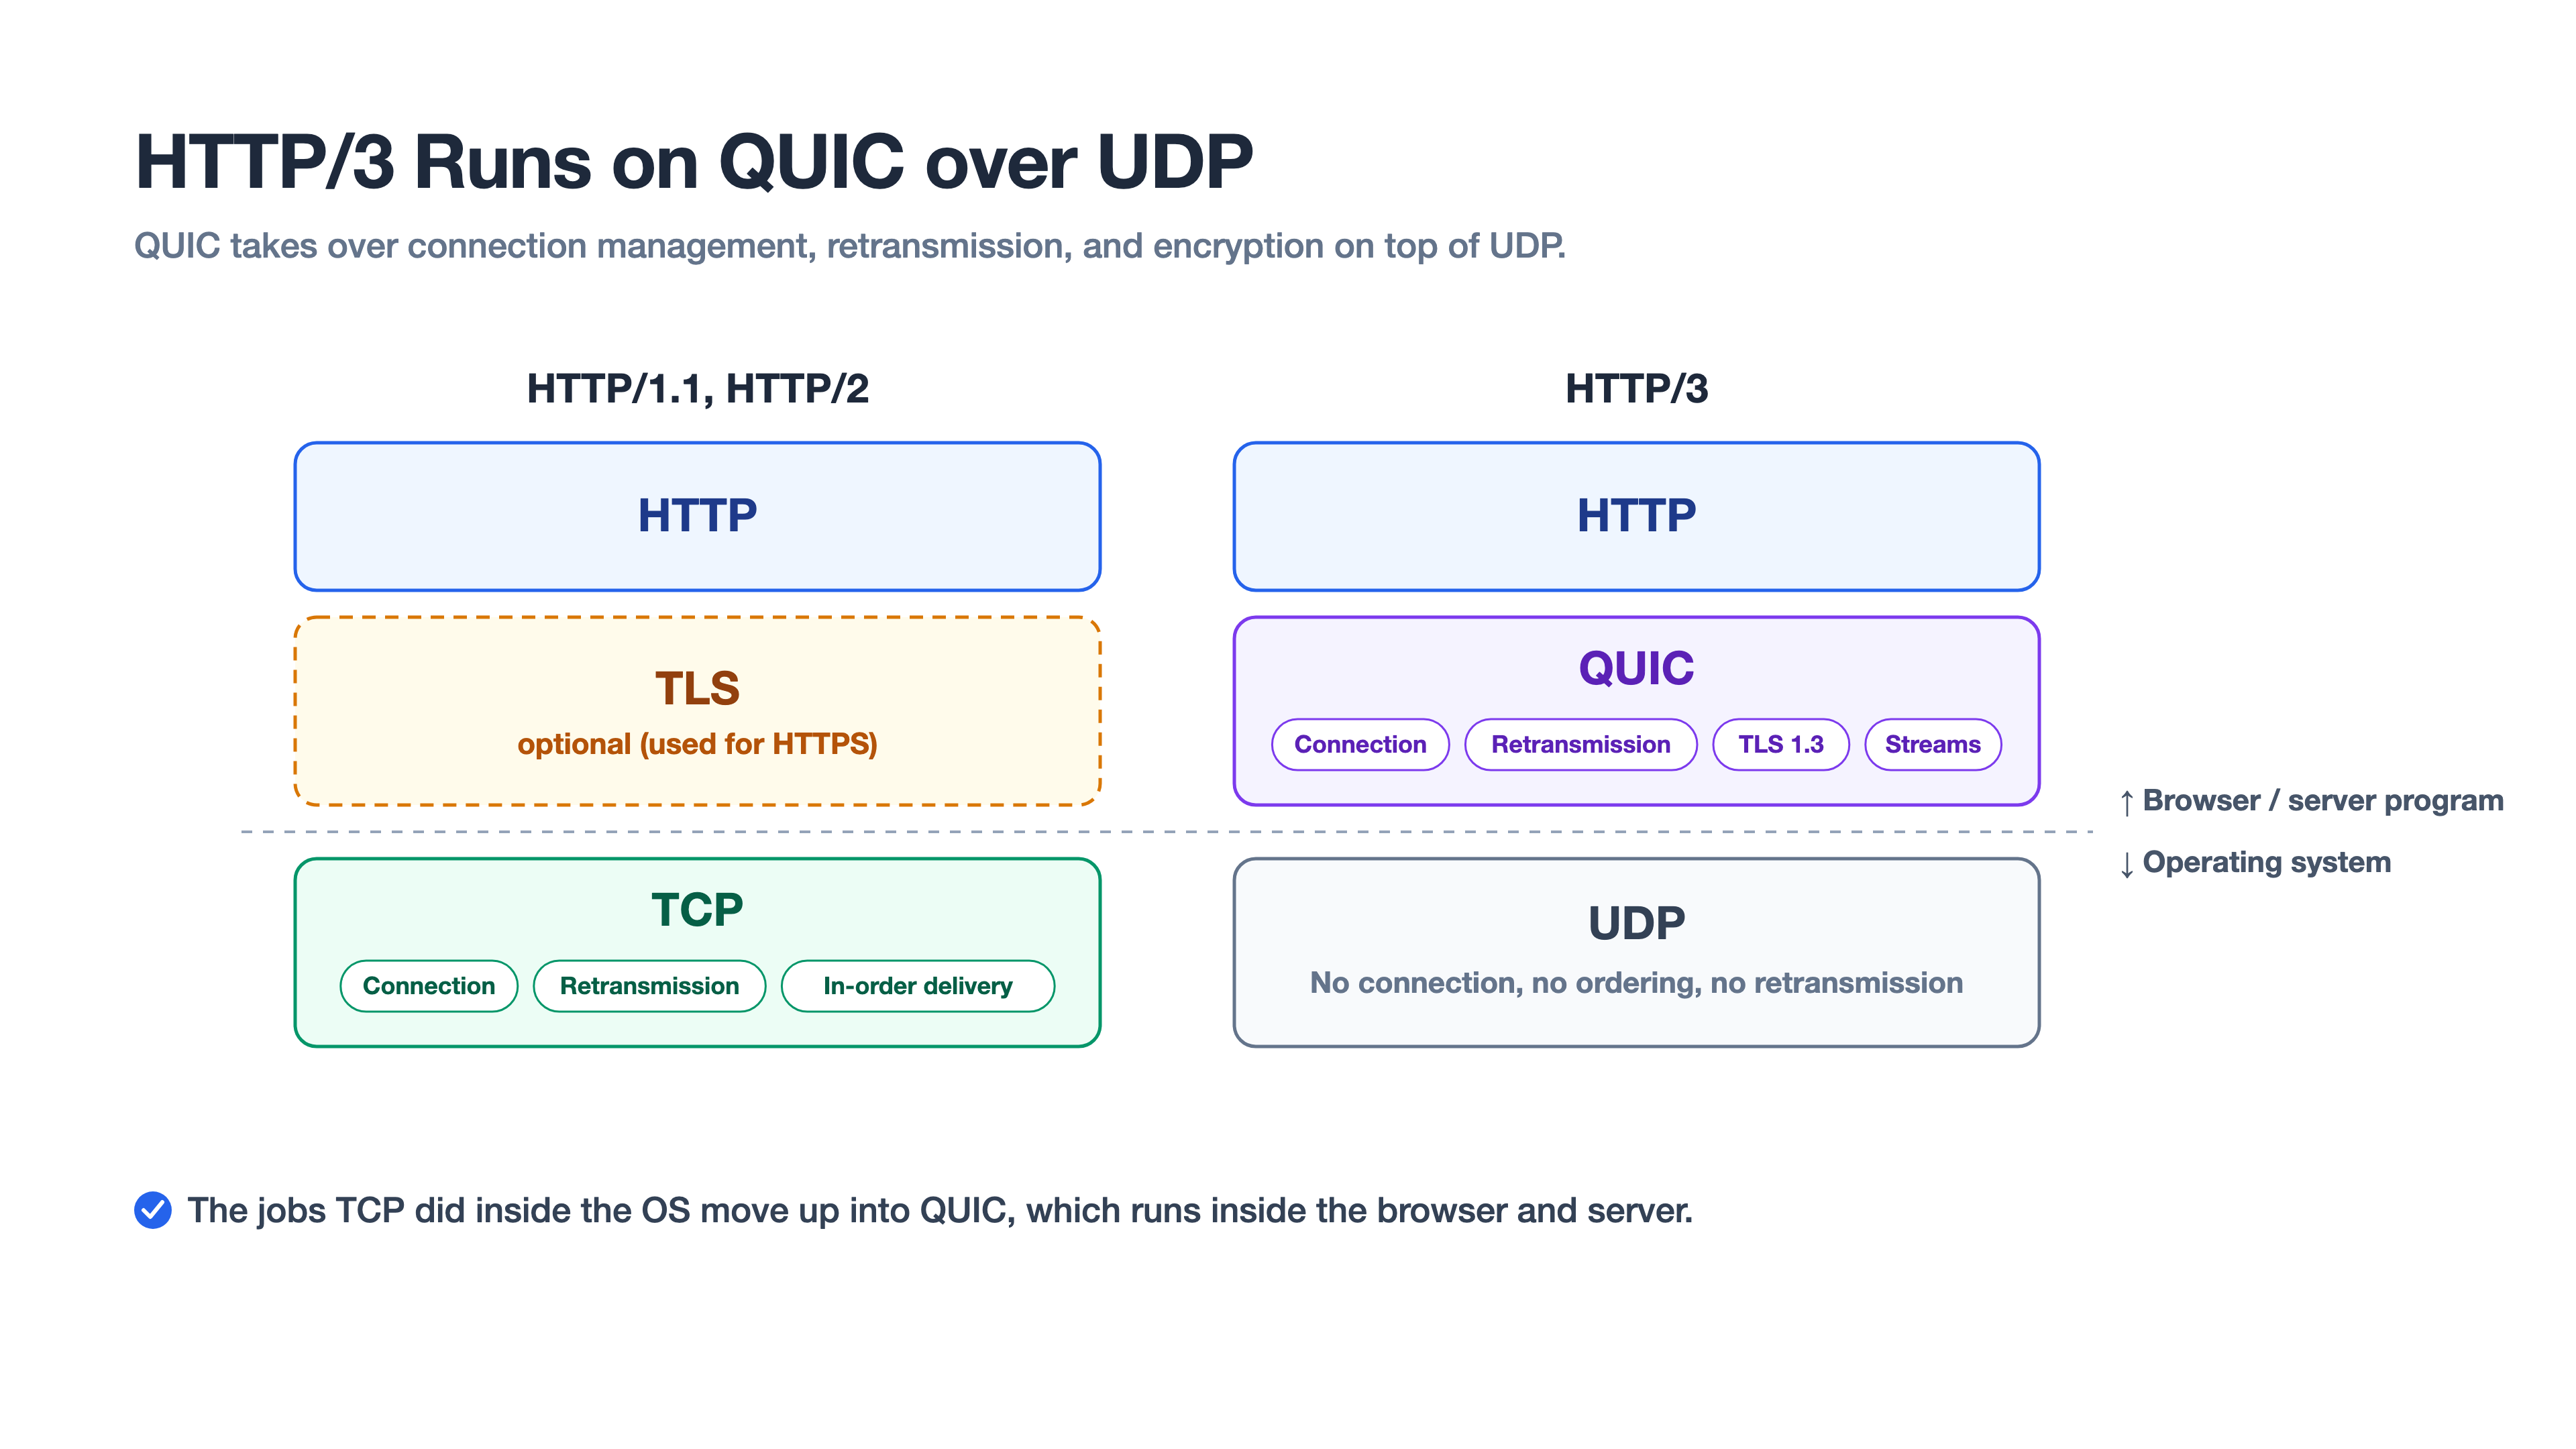 HTTP/3에서는 TCP가 하던 연결 관리와 재전송, TLS의 암호화를 QUIC이 맡는다
UDP 자체는 연결을 맺지 않고 순서나 도착도 보장하지 않는 비연결형 프로토콜입니다. 하지만 QUIC이 그 위에서 연결 관리, 재전송, 암호화를 직접 맡습니다. 앞의 (4)에서 “QUIC도 연결을 맺고 재사용한다”고 한 것이 바로 이 뜻입니다. HTTP/3가 비연결형으로 동작하는 것이 아니라, UDP를 바탕으로 TCP보다 나은 연결을 새로 만든 것에 가깝습니다.
TCP를 직접 고치지 않은 이유는 TCP가 운영체제와 네트워크 장비 깊숙이 구현되어 있어서, 바꾸려면 전 세계의 장비를 바꿔야 하기 때문입니다. UDP는 단순해서 그 위에 새로운 규칙을 얹기가 훨씬 쉽습니다.
무엇이 빨라졌을까?
HTTP/3는 속도 측면에서 큰 개선이 이루어졌는데, 크게 두 가지 이유가 있습니다.
첫째, TCP의 HOL 블로킹이 사라졌습니다. QUIC은 스트림을 직접 구분하기 때문에, 한 스트림의 패킷이 유실되어도 그 스트림만 기다리고 나머지 스트림은 계속 진행합니다.
둘째, 연결을 더 빨리 맺습니다. TCP와 TLS를 함께 쓰면, TCP 연결(3-way handshake)을 맺은 뒤 TLS 암호화 연결을 따로 한 번 더 맺어야 합니다. QUIC은 이 두 과정을 하나로 합쳐서, 처음 연결할 때 주고받는 횟수가 줄어듭니다. 이전에 연결한 적이 있는 서버라면 첫 요청부터 바로 데이터를 보낼 수도 있습니다.
한눈에 보기
| 버전 | 등장 | 해결하려던 문제 | 주요 변화 |
|---|---|---|---|
| HTTP/0.9 | 1991 | - | GET만 가능, 한 줄 요청, 헤더 없음 |
| HTTP/1.0 | 1996 | 부가 정보를 담을 수 없다 | HEAD·POST 등 메서드 추가, 상태 코드, 헤더 지원 |
| HTTP/1.1 | 1997 | 요청마다 연결을 새로 맺는다 | 지속 연결, 파이프라이닝, Host 필수, 콘텐츠 협상 |
| HTTP/2 | 2015 | 응답 순서 때문에 서로 기다린다 | 바이너리 프레임, 헤더 압축, 멀티플렉싱, 서버 푸시 |
| HTTP/3 | 2022 | TCP의 패킷 유실이 모든 스트림을 막는다 | UDP 기반 QUIC, 스트림별 독립 전송, 빠른 연결 수립 |
마무리를 하면서
지금까지 HTTP가 무엇인지부터 시작해서, HTTP의 4가지 특성, 메시지 구조, 그리고 HTTP/0.9부터 HTTP/3까지 어떻게 발전해 왔는지 알아보았습니다. 내용이 조금 길었지만, HTTP를 공부한다면 꼭 알고 넘어가야 하는 주제들로 가져와 보았습니다.
다음 포스팅에서는 이번 글에서 잠깐 등장했던 메서드와 상태 코드에 대해 알아보겠습니다. 감사합니다.